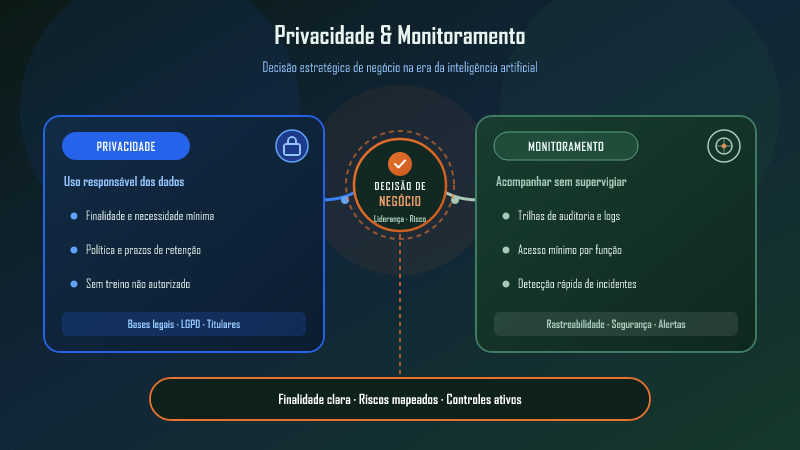
Privacidade e monitoramento passam a ser uma decisão de negócio
A adoção de IA nas empresas exige definir acessos, monitoramento, retenção e responsabilidades. Privacidade e segurança deixaram de ser apenas questões técnicas: hoje são parte da estratégia do negócio.
Introdução
Durante muito tempo, privacidade foi tratada como uma responsabilidade quase exclusiva do departamento jurídico. O monitoramento, por sua vez, parecia pertencer apenas às áreas de tecnologia e segurança da informação.
A expansão da inteligência artificial dentro das empresas tornou essa divisão cada vez menos realista.
Atualmente, uma ferramenta de IA pode resumir documentos, consultar sistemas internos, apoiar o atendimento, analisar currículos, classificar solicitações e até executar etapas de um processo. Para realizar essas tarefas, ela precisa acessar informações. Algumas são públicas. Outras pertencem à empresa, aos clientes, aos fornecedores ou aos profissionais que trabalham nela.
É nesse ponto que privacidade e monitoramento deixam de ser apenas temas técnicos e passam a fazer parte da estratégia empresarial — em linha direta com a transição do piloto isolado para a IA integrada à operação e a reflexão sobre usar IA versus implementar IA.
A pergunta já não é somente “a ferramenta funciona?”. Também é necessário saber:
- Quais dados ela utiliza?
- Para qual finalidade?
- Quem pode acessá-los?
- Por quanto tempo as informações permanecem armazenadas?
- Elas podem ser usadas para treinar modelos?
- Como a empresa acompanha o que o sistema está fazendo?
- Quem responde quando algo sai do esperado?
Isso não significa impedir o uso da tecnologia. Significa criar condições para que ela seja útil sem abrir caminhos desnecessários para vazamentos, usos indevidos, conflitos internos ou decisões que ninguém consegue explicar.
Desenvolvimento
O que privacidade significa na prática?
Privacidade não significa simplesmente manter todas as informações em segredo. No contexto empresarial, ela está relacionada ao uso responsável dos dados.
Isso envolve:
- Definir uma finalidade clara para a coleta;
- Utilizar apenas as informações realmente necessárias;
- Proteger os dados contra acessos indevidos;
- Informar as pessoas sobre como suas informações serão utilizadas;
- Estabelecer responsabilidades e formas de acompanhamento.
A Lei Geral de Proteção de Dados Pessoais (LGPD) estabelece princípios como finalidade, adequação, necessidade, transparência, segurança, prevenção e responsabilização.
Em termos simples, a empresa precisa saber por que trata determinado dado, usar apenas o necessário para esse objetivo e ser capaz de demonstrar que tomou decisões responsáveis.
A lei também determina a adoção de medidas técnicas e administrativas para proteger os dados pessoais contra acessos não autorizados, perdas, alterações ou outras formas inadequadas de tratamento.
Quando uma solução de IA entra no processo, essas obrigações não desaparecem. Pelo contrário: pode surgir uma cadeia mais longa de tratamento de dados.
A informação pode sair de um sistema, passar por uma integração, chegar ao fornecedor da ferramenta, gerar uma resposta e ser registrada em outro ambiente.
Sem um mapa desse percurso, a empresa pode perder a noção de onde o dado está, quem consegue acessá-lo e o que pode ser feito com ele.
Monitorar não é vigiar tudo
O monitoramento é necessário para saber se uma solução de IA está funcionando como deveria. A empresa precisa conseguir identificar erros, acessos indevidos, respostas inadequadas, exposição de informações e ações realizadas pelo sistema.
Mas monitorar não significa registrar tudo, o tempo todo e sem critério.
Existe uma diferença importante entre acompanhar uma operação e criar uma coleta permanente de dados sobre as pessoas. Um registro pode ajudar a descobrir que uma ferramenta acessou um documento indevido. Ao mesmo tempo, um sistema que grava conversas, telas, localização ou atividades profissionais sem uma necessidade clara pode gerar riscos jurídicos, culturais e trabalhistas.
O Information Commissioner’s Office (ICO), autoridade britânica de proteção de dados, recomenda que o monitoramento de trabalhadores seja lícito, justo, necessário e proporcional. A entidade também orienta que as organizações avaliem se existe uma alternativa menos invasiva para alcançar a mesma finalidade.
A lógica é simples: monitorar apenas porque a tecnologia permite não é uma justificativa suficiente.
A empresa precisa explicar qual problema pretende resolver. Pode ser:
- Prevenção de fraudes;
- Segurança da informação;
- Investigação de falhas;
- Controle de qualidade;
- Cumprimento de uma obrigação;
- Proteção de informações estratégicas.
A partir disso, deve escolher o menor nível de coleta capaz de atender à finalidade definida.
Um mapa simples dos riscos
Os riscos relacionados ao uso de dados e inteligência artificial podem aparecer em diferentes pontos da operação.
Entrada de dados
O primeiro risco surge no momento em que uma informação é enviada à ferramenta.
Um profissional pode copiar um contrato inteiro quando precisava analisar apenas uma cláusula. Uma equipe pode inserir dados de clientes em um serviço que não foi aprovado pela empresa. Um chatbot interno pode receber informações de saúde, documentos pessoais ou detalhes financeiros sem estar preparado para tratar esse conteúdo.
A facilidade de uso cria uma falsa sensação de informalidade. Uma caixa de texto parece inofensiva, mas o conteúdo inserido nela pode iniciar uma nova operação de tratamento de dados.
Acesso e permissões
Nem todo sistema precisa enxergar tudo.
Uma solução voltada ao atendimento pode precisar consultar o histórico de uma solicitação, mas não necessariamente todos os dados cadastrais do cliente.
Da mesma forma, um agente que organiza propostas comerciais pode precisar ler determinados documentos, sem ter autorização para alterar preços ou enviar arquivos.
Permissões amplas facilitam a implantação, mas aumentam o impacto de um erro. O princípio mais seguro é conceder apenas os acessos necessários para a função definida.
Retenção
Retenção é o período durante o qual uma informação permanece armazenada.
Esse prazo pode variar de acordo com a finalidade, a obrigação legal, o contrato e as configurações da ferramenta. Por isso, não existe uma resposta universal para a pergunta: “por quanto tempo devemos guardar os dados?”.
O problema aparece quando ninguém sabe a resposta.
Se a empresa não entende a política de retenção de um fornecedor, pode manter cópias de informações por mais tempo do que precisa. Também pode descobrir tarde demais que não consegue excluir um conteúdo, atender a uma solicitação do titular ou recuperar registros importantes para investigar um incidente.
Uso para treinamento de modelos
Outro ponto importante é saber se os dados enviados poderão ser utilizados para desenvolver ou melhorar modelos de inteligência artificial.
As regras podem variar entre ferramentas, planos e contratos. Algumas plataformas oferecem controles diferentes para contas corporativas e pessoais. Em certos casos, o uso para treinamento pode ser desativado. Em outros, as condições dependem do serviço contratado.
A empresa não deve presumir que os dados não serão utilizados para treinamento se essa garantia não estiver claramente apresentada nos termos, nas configurações ou no contrato.
Saída e ações do sistema
O risco não termina quando a IA gera uma resposta.
Uma saída pode reproduzir uma informação sensível, misturar contextos ou revelar conteúdo a uma pessoa sem autorização.
Se o sistema também puder executar ações, o impacto potencial aumenta. Ele pode enviar uma mensagem, atualizar um cadastro, criar um pagamento ou modificar um registro.
Quanto maior a capacidade de ação, maior deve ser a clareza sobre limites, aprovações, registros e formas de interrupção.
O AI Risk Management Framework, do National Institute of Standards and Technology (NIST), recomenda que os riscos de IA sejam tratados em conjunto com riscos organizacionais já conhecidos, como privacidade e segurança cibernética.
O framework propõe quatro funções contínuas:
- Governar;
- Mapear;
- Medir;
- Gerenciar.
Isso significa que não basta avaliar uma ferramenta antes da compra. É preciso acompanhar seu funcionamento ao longo do tempo.
Cinco perguntas essenciais antes de usar IA com dados corporativos
1. Qual dado a ferramenta realmente precisa?
Comece pela finalidade, não pela facilidade técnica.
Se o objetivo é classificar chamados por assunto, talvez a ferramenta não precise conhecer o nome completo, o CPF ou todo o histórico do cliente.
Se a tarefa é resumir um documento, pode ser possível ocultar informações de identificação antes do envio.
O princípio da necessidade, previsto na LGPD, orienta que o tratamento seja limitado ao mínimo necessário para alcançar a finalidade desejada.
Coletar menos dados reduz os riscos e também simplifica a gestão.
2. Onde a informação será armazenada e por quanto tempo?
É importante verificar:
- Onde ocorre o processamento;
- Quais registros são mantidos;
- Qual é o prazo de retenção;
- Como funciona a exclusão;
- Se existem transferências internacionais;
- Quais fornecedores secundários participam da operação.
A resposta não deve depender apenas de uma página comercial. Ela precisa ser confirmada na documentação do serviço, nas configurações disponíveis e, quando necessário, no contrato.
3. Os dados podem ser usados para treinar modelos?
Essa pergunta deve ser feita de forma direta.
Além de verificar se existe uso para treinamento, a empresa precisa saber se essa regra vale para todos os recursos do produto, se depende de alguma configuração e se os dados podem ser revisados por pessoas durante processos de suporte ou melhoria.
Caso o fornecedor permita desativar esse uso, alguém deve ser responsável por confirmar a configuração e acompanhar possíveis mudanças nos termos do serviço.
4. Quem pode acessar o quê?
O acesso precisa refletir a função de cada pessoa e de cada sistema.
Contas compartilhadas, permissões genéricas e integrações com privilégios excessivos dificultam a identificação de quem realizou determinada ação. Também aumentam o alcance de credenciais comprometidas ou de erros cotidianos.
É recomendável:
- Definir perfis de acesso;
- Utilizar contas individuais;
- Revisar permissões periodicamente;
- Retirar acessos que deixaram de ser necessários;
- Registrar ações relevantes.
A ANPD inclui controle de acesso, políticas de segurança, treinamento, cópias de segurança e atualização de sistemas entre as medidas importantes para a proteção de dados, inclusive em organizações de pequeno porte.
5. Como saberemos se algo deu errado?
Uma solução corporativa precisa deixar rastros suficientes para investigação e melhoria.
Isso pode incluir:
- Registros de acesso;
- Data e horário da ação;
- Origem da solicitação;
- Documentos consultados;
- Ação executada;
- Aprovação humana;
- Resultado obtido.
Nem todo registro precisa armazenar o conteúdo completo. Em alguns casos, metadados e identificadores oferecem a rastreabilidade necessária com menor exposição de informações.
Também é importante definir alertas, responsáveis e um plano de resposta.
Se houver suspeita de exposição de dados:
- Quem avaliará o ocorrido?
- Quem poderá suspender a integração?
- Como o incidente será documentado?
- Clientes ou autoridades precisarão ser comunicados?
A LGPD exige que controladores e operadores mantenham registros das operações de tratamento, especialmente quando baseadas em legítimo interesse. Esses registros ajudam a demonstrar o que aconteceu e quais medidas foram tomadas.
Quem deve participar dessa decisão?
Privacidade e monitoramento não devem ficar sob responsabilidade de uma única área.
A liderança do negócio precisa definir a finalidade da iniciativa e o nível de risco aceitável. A área responsável pelo processo conhece as necessidades reais e as exceções da rotina.
A tecnologia avalia integrações, acessos e funcionamento. A segurança da informação analisa controles e possíveis incidentes. O jurídico e a área de privacidade verificam bases legais, contratos e direitos dos titulares.
Quando houver monitoramento de profissionais, também é importante considerar os efeitos sobre o ambiente de trabalho.
A responsabilidade não desaparece quando a tecnologia é terceirizada.
De acordo com as orientações da ANPD, o controlador é quem toma as principais decisões sobre o tratamento de dados pessoais e define sua finalidade. O operador realiza o tratamento em nome do controlador.
A classificação depende do papel efetivamente desempenhado, não apenas do nome utilizado no contrato.
Por isso, contratar um fornecedor não transfere automaticamente todas as responsabilidades. A empresa continua precisando entender a operação e estabelecer controles compatíveis com o risco.
Checklist antes de contratar uma ferramenta de IA
Antes de aprovar uma solução, verifique se a empresa consegue responder:
- Qual processo será apoiado?
- Qual resultado é esperado?
- Quais categorias de dados entrarão na ferramenta?
- Existem dados pessoais, sensíveis, estratégicos ou protegidos por sigilo?
- Há uma base legal adequada para o tratamento?
- É possível reduzir, anonimizar ou ocultar parte das informações?
- Onde os dados serão processados e armazenados?
- Qual é o prazo de retenção?
- Como funciona a exclusão?
- Os dados podem ser utilizados para treinamento?
- Há fornecedores secundários envolvidos?
- Quais mecanismos de segurança estão disponíveis?
- A ferramenta oferece registros de uso e ações?
- Quem poderá consultar, alterar, exportar ou apagar informações?
- Existe revisão humana para decisões de maior impacto?
- O contrato define responsabilidades e procedimentos para incidentes?
- É possível interromper a ferramenta rapidamente?
- Quem será responsável pela operação e pela revisão periódica?
Se muitas respostas ainda forem “não sabemos”, o próximo passo não precisa ser cancelar o projeto.
Pode ser mais adequado reduzir o escopo, retirar dados sensíveis, limitar acessos ou testar a solução em um ambiente controlado.
Perguntas frequentes
Toda ferramenta de IA representa um risco à privacidade?
Não da mesma forma. O risco depende dos dados utilizados, da finalidade, das configurações, das integrações e das ações permitidas.
Uma ferramenta usada com informações públicas está em um contexto diferente de um agente conectado a sistemas financeiros ou cadastros de clientes.
Basta retirar o nome para tornar um dado anônimo?
Nem sempre. Outros elementos podem permitir a identificação direta ou indireta de uma pessoa.
A anonimização precisa considerar o conjunto das informações e a possibilidade razoável de reidentificação.
Monitorar o uso da IA resolve o problema?
Não sozinho.
O monitoramento ajuda a detectar desvios, mas precisa ser acompanhado de limites de acesso, treinamento, regras de uso, revisão humana e resposta a incidentes.
Registrar uma ação inadequada não impede que ela aconteça.
Empresas pequenas também precisam cuidar disso?
Sim.
O tamanho da empresa influencia a complexidade dos controles, mas não elimina a necessidade de proteger dados. Medidas simples, como contas individuais, permissões mínimas, políticas de uso, treinamento e revisão de fornecedores, já criam uma base mais segura.
É necessário produzir um Relatório de Impacto?
A necessidade depende do contexto e do risco da operação.
O Relatório de Impacto à Proteção de Dados Pessoais descreve processos que podem gerar riscos às liberdades e aos direitos fundamentais, além das medidas utilizadas para reduzi-los.
A ANPD pode solicitar esse documento em determinadas situações. Sua elaboração também pode ajudar a organizar decisões de maior risco.
Privacidade não é uma etapa final do projeto
Quando a privacidade entra apenas na revisão jurídica, muitas decisões importantes já foram tomadas: o fornecedor foi escolhido, a integração está pronta e os dados já começaram a circular.
Nesse momento, corrigir o projeto pode ser mais caro, lento e desgastante.
Uma abordagem mais consistente começa pelo processo. Primeiro, a empresa define o que precisa resolver. Depois, identifica quais dados são indispensáveis, quais riscos estão envolvidos e quais controles devem acompanhar a solução.
Só então escolhe a ferramenta e o nível de monitoramento adequado.
Essa ordem não reduz a inovação. Ela evita que velocidade seja confundida com falta de direção.
A inteligência artificial pode apoiar processos relevantes sem transformar a empresa em um ambiente de vigilância permanente ou criar uma caixa-preta sobre os próprios dados.
Para isso, privacidade, retenção, permissões, contratos e monitoramento precisam ser discutidos como partes da mesma decisão.
Não é apenas uma questão de conformidade. É uma escolha sobre como a empresa deseja crescer, como trata as pessoas e quanto controle mantém sobre a própria operação.
Conclusão
A pergunta mais importante não é apenas “qual ferramenta de IA devemos contratar?”.
Antes dela, é preciso perguntar:
Quais dados estão envolvidos, quais riscos existem e quais controles precisam acompanhar essa decisão?
Empresas que respondem a essas perguntas conseguem adotar inteligência artificial com mais clareza, segurança e responsabilidade.
Sua empresa sabe quais dados suas ferramentas de IA acessam, por quanto tempo os armazenam e como esse uso é monitorado?
A KaiporaLabs pode ajudar a mapear o processo e avaliar oportunidades de adoção segura da inteligência artificial.
Leituras relacionadas
- Dados corporativos e IA: o que perguntar antes de conectar sistemas — perguntas essenciais sobre privacidade, retenção e segurança
- Do piloto isolado para a IA integrada à operação — critérios e governança para transformar experimentos em rotina
- Usar IA não é implementar IA — da curiosidade distribuída à vantagem competitiva
Fontes
- Presidência da República. Lei Geral de Proteção de Dados Pessoais (LGPD) — Lei nº 13.709/2018.
- Autoridade Nacional de Proteção de Dados (ANPD). Guia Orientativo sobre Tratamento de Dados Pessoais com Base no Legítimo Interesse.
- Autoridade Nacional de Proteção de Dados (ANPD). Guia Orientativo de Segurança da Informação para Agentes de Tratamento de Pequeno Porte.
- Autoridade Nacional de Proteção de Dados (ANPD). Guia Orientativo: Definições dos Agentes de Tratamento de Dados Pessoais e do Encarregado.
- Autoridade Nacional de Proteção de Dados (ANPD). Guia Orientativo: Relatório de Impacto à Proteção de Dados Pessoais (RIPD).
- Information Commissioner’s Office (ICO). Data protection and monitoring workers.
- National Institute of Standards and Technology (NIST). AI Risk Management Framework (AI RMF 1.0).