As quatro métricas de um agente corporativo útil
Responder bem não basta. Avalie agentes pelo tempo até uso, trabalho concluído, escalonamento e impacto no negócio — e leia as métricas em conjunto.
Introdução
Uma IA pode responder muito bem e, ainda assim, não melhorar a operação. Para avaliar um agente de verdade, é preciso observar o trabalho que ele consegue concluir, a intervenção humana necessária e o impacto que produz no negócio.
Imagine que uma empresa implemente um agente de inteligência artificial para ajudar a equipe a lidar com solicitações internas.
Durante os testes, ele parece funcionar muito bem. Entende perguntas, escreve respostas coerentes, consulta informações e interpreta diferentes pedidos.
Ao final da demonstração, alguém pergunta:
“Mas isso está funcionando?”
A pergunta parece simples. Afinal, acabamos de ver o agente em ação.
Mas existe outra questão por trás dela:
“Isso está melhorando alguma coisa na operação?”
As duas perguntas não são equivalentes — e essa distinção se conecta ao caminho do piloto isolado para a IA integrada à operação e à diferença entre usar IA e implementá-la de fato.
Desenvolvimento
Um sistema pode produzir respostas tecnicamente boas e, ainda assim, exigir tanta revisão humana que quase nenhum trabalho seja retirado da equipe. Pode concluir tarefas, mas custar mais do que o processo anterior. Pode ser rápido, mas falhar justamente nos casos de maior risco. Também pode apresentar bons resultados em um teste controlado e se comportar de forma diferente quando encontra dados, exceções e situações reais.
Por isso, medir agentes corporativos exige mais do que acompanhar a qualidade das respostas.
A IBM apresenta a conclusão de tarefas, a taxa de erros, o custo e a latência como algumas das dimensões que podem ser observadas na avaliação de agentes. A empresa também aborda aspectos como uso correto de ferramentas, aderência a políticas e experiência do usuário.
A Microsoft, em suas orientações sobre o valor de agentes, relaciona métricas técnicas e operacionais a indicadores como resolução, escalonamento, tempo de ciclo, custo por transação, horas economizadas e, dependendo do caso de uso, indicadores ligados à receita.
O NIST, Instituto Nacional de Padrões e Tecnologia dos Estados Unidos, recomenda que sistemas de inteligência artificial sejam avaliados e monitorados ao longo de seu ciclo de vida, considerando tanto o desempenho quanto os riscos e impactos associados ao uso.
A ideia central é simples: um agente corporativo não deve ser avaliado apenas por parecer inteligente. Ele precisa ser avaliado pelo trabalho que realiza dentro de um processo.
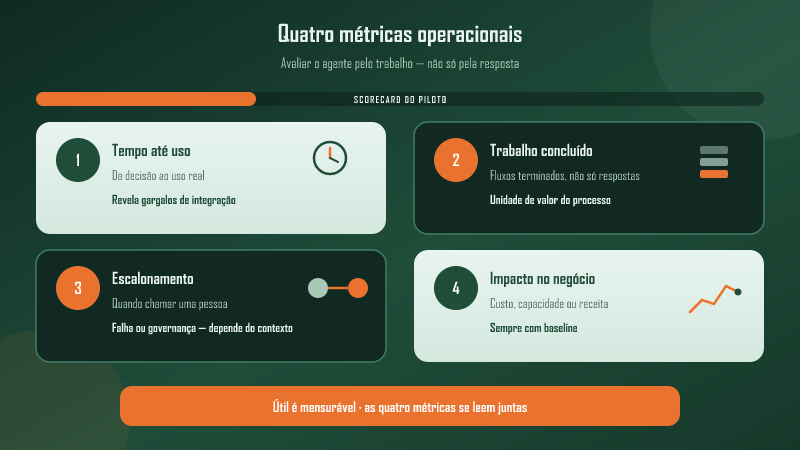
Para tornar essa avaliação mais prática, a KaiporaLabs propõe observar quatro dimensões operacionais:
- tempo até uso;
- volume de trabalho concluído;
- taxa de escalonamento;
- impacto em receita, custo ou outros indicadores relevantes do negócio.
Essas quatro métricas não substituem avaliações técnicas, de segurança ou de qualidade. Elas acrescentam uma camada frequentemente esquecida: a operação.
1. Tempo até uso: quanto demora para sair da demonstração e entrar no processo?
Existe uma diferença significativa entre colocar um modelo para responder a algumas perguntas e integrar um agente a uma operação real.
Em uma demonstração, é possível controlar o contexto, selecionar exemplos e limitar as exceções.
Na empresa, surgem outras questões:
- Quais sistemas o agente precisa acessar?
- Existem integrações disponíveis?
- Os dados estão organizados?
- Quem autoriza os acessos?
- Quais ações o agente poderá executar?
- Como os resultados serão registrados?
- O que acontecerá quando algo der errado?
- Quem será responsável pelo acompanhamento?
Por isso, a primeira métrica não começa quando o agente entra em produção. Ela começa antes:
quanto tempo existe entre a decisão de testar aquele caso de uso e o momento em que as pessoas conseguem utilizá-lo adequadamente no processo real?
Aqui, chamamos esse indicador de tempo até uso.
Ele pode ser observado em diferentes etapas: início do projeto, primeiro teste funcional, primeira integração com sistemas reais, primeiro uso controlado e início da operação.
O objetivo não é transformar velocidade em uma competição.
Um projeto que envolve informações financeiras, dados pessoais ou decisões de alto impacto naturalmente pode exigir mais validações do que uma automação interna de baixo risco.
O valor dessa métrica está em tornar os obstáculos visíveis.
Se um agente leva semanas para ser desenvolvido, mas meses para obter os acessos necessários, talvez o gargalo não esteja no modelo.
Se a integração é rápida, mas ninguém utiliza o sistema depois da implantação, existe outro problema a investigar.
Se cada alteração exige reconstruir uma parte significativa da solução, talvez a arquitetura esteja criando uma dívida operacional que ainda não aparece na demonstração.
Tempo até uso não mede apenas velocidade. Ele ajuda a revelar a distância entre uma prova de conceito e uma capacidade realmente incorporada ao trabalho.
2. Volume de trabalho concluído: o agente está respondendo ou terminando tarefas?
Considere dois agentes.
O primeiro recebe mil solicitações durante o mês e responde a todas.
O segundo recebe quinhentas e conclui quatrocentos fluxos completos.
Qual produziu mais valor?
Ainda não há informação suficiente para responder.
É preciso saber o que significa “concluir” naquele processo.
Essa definição é fundamental porque atividade não é sinônimo de resultado.
Um agente comercial pode escrever uma resposta para um lead sem atualizar o CRM. Um agente de suporte pode classificar corretamente um chamado, mas não resolver o problema. Um agente financeiro pode extrair informações de uma nota fiscal, mas ainda exigir que uma pessoa copie os dados para outro sistema.
Todas essas ações podem ser úteis. Mas são diferentes de concluir o trabalho definido como objetivo.
A IBM descreve a conclusão de tarefas, ou task completion, como a proporção de tarefas ou objetivos concluídos satisfatoriamente pelo agente em relação ao total de tentativas. A Microsoft utiliza uma lógica semelhante em métricas como a taxa de resolução, que acompanha a parcela de sessões que chega a um resultado resolvido.
Para medir isso em uma empresa, primeiro é necessário definir claramente o que será considerado uma unidade de trabalho.
Em um fluxo de atendimento, pode ser uma solicitação resolvida.
Em contas a pagar, pode ser um documento processado corretamente até determinada etapa.
Em vendas, pode ser uma oportunidade qualificada e registrada conforme os critérios definidos.
Em recursos humanos, pode ser uma solicitação interna classificada, respondida e encaminhada corretamente.
Só então faz sentido acompanhar o volume.
Isso evita uma armadilha comum: comemorar números que mostram muita atividade, mas dizem pouco sobre o trabalho efetivamente concluído.
Um agente que realiza dez chamadas a ferramentas para cada solicitação pode parecer muito ativo nos registros de execução. Mas essas dez chamadas não significam dez resultados.
A unidade importante é aquela que representa valor para o processo.
3. Taxa de escalonamento: quando o agente precisa chamar uma pessoa?
Um bom agente corporativo não precisa resolver tudo sozinho.
Na verdade, em muitos processos, seria preocupante se tentasse.
Algumas situações devem ser encaminhadas para uma pessoa: exceções, informações insuficientes, decisões de alto impacto, operações acima de determinado limite ou casos para os quais o agente não possui autorização.
É nesse ponto que entra a taxa de escalonamento.
De maneira simplificada, ela observa qual parcela das situações atendidas pelo agente precisa de intervenção humana.
A Microsoft define a taxa de escalonamento, no contexto do Copilot Studio, como a parcela de sessões transferidas por mecanismos de escalonamento. Em outros sistemas, a forma de calcular esse indicador pode variar.
Mas existe uma nuance importante:
uma taxa alta não é automaticamente ruim, e uma taxa baixa não é automaticamente boa.
Imagine um agente que ajuda funcionários a solicitar férias. Para perguntas simples e verificações de regras, pode fazer sentido esperar pouca intervenção humana.
Agora imagine um agente que analisa situações relacionadas a pagamentos de alto valor. Nesse segundo cenário, escalar determinadas operações pode ser exatamente o comportamento esperado.
Por isso, essa métrica só funciona quando acompanhada de contexto.
É preciso perguntar:
- Por que o agente escalou?
- A escalada estava prevista?
- O caso realmente precisava de uma pessoa?
- Existem tipos específicos de solicitação gerando a maior parte dos encaminhamentos?
- O agente está escalando porque reconheceu corretamente seus limites ou porque não consegue realizar tarefas que deveria conseguir?
Essa diferença é essencial.
Uma escalada pode representar uma falha de capacidade ou um controle funcionando corretamente.
Se o agente está autorizado a processar solicitações rotineiras, mas deve pedir aprovação humana quando uma condição específica aparece, o escalonamento nesses casos não é um defeito.
É governança.
O problema surge quando ele encaminha grande parte das solicitações rotineiras porque não consegue interpretá-las corretamente.
Da mesma forma, uma taxa de escalonamento muito baixa merece investigação quando o processo contém exceções importantes. O agente pode estar resolvendo tudo corretamente — ou pode não estar reconhecendo situações nas quais deveria interromper a execução.
O número sozinho não responde.
Ele indica onde é preciso olhar.
4. Impacto em receita ou custo: o que mudou para o negócio?
Essa é a métrica mais próxima da pergunta que costuma aparecer em qualquer projeto corporativo:
“Isso vale o investimento?”
Não existe uma fórmula universal que transforme automaticamente cada ação de um agente em retorno financeiro.
O impacto depende do processo.
Em uma operação de atendimento, a mudança pode aparecer no custo por solicitação, no tempo de resolução ou na capacidade da equipe.
Em uma atividade administrativa, pode surgir na redução do tempo necessário para processar cada item.
Em vendas, pode haver relação com capacidade de atendimento, conversão, retenção ou quantidade de oportunidades trabalhadas.
A Microsoft recomenda conectar os agentes aos direcionadores de valor do processo. Em eficiência, cita métricas como horas economizadas, tempo de ciclo, taxa de processos sem intervenção e custo por transação. Para casos relacionados à receita, apresenta exemplos como conversão, retenção, vendas adicionais e capacidade dos profissionais.
Isso leva a uma regra importante:
não escolha uma métrica financeira porque ela parece impressionante. Escolha aquela que corresponde ao processo que o agente deveria melhorar.
Se o objetivo era reduzir o tempo necessário para processar solicitações internas, tentar atribuir diretamente uma mudança na receita da empresa ao agente provavelmente acrescentará mais suposições do que informação.
Nesse caso, custo por tarefa, tempo de ciclo ou capacidade da equipe podem ser indicadores muito mais úteis.
Também é indispensável definir o baseline, ou linha de base. Ele é o retrato do processo antes da entrada do agente em operação.
Sem saber como o processo funcionava antes, fica difícil dizer o que mudou.
Antes do piloto, registre pelo menos algumas características do fluxo atual: volume, tempo, intervenção humana, erros relevantes e custo, quando for possível medi-lo com segurança razoável.
Depois, compare condições equivalentes.
O objetivo não é fabricar um retorno sobre o investimento. É construir evidências suficientes para decidir se vale a pena continuar, ajustar ou interromper o projeto.
As quatro métricas precisam ser lidas juntas
Nenhuma das quatro métricas deve ser interpretada isoladamente.
Imagine que o volume de trabalho concluído tenha aumentado bastante. Isso parece positivo. Mas e se a taxa de escalonamento também tiver aumentado e cada tarefa ainda exigir revisão humana?
Ou imagine que o agente tenha reduzido drasticamente o número de encaminhamentos. Parece um bom resultado. Mas e se isso tiver acontecido porque ele passou a executar ações que deveriam ser revisadas?
Talvez o tempo até uso seja excelente, mas o impacto operacional seja irrelevante.
Ou talvez o retorno seja promissor, mas o agente esteja operando fora dos limites de risco definidos pela organização.
A avaliação precisa combinar os sinais.
Essa preocupação está alinhada à orientação do NIST sobre medição de sistemas de IA. O AI Risk Management Framework recomenda utilizar métodos quantitativos, qualitativos ou mistos para avaliar e monitorar riscos e impactos, testar os sistemas antes da implantação e continuar acompanhando seu funcionamento durante a operação.
O NIST também destaca que a escolha das métricas depende do propósito, do público e das necessidades da avaliação. Portanto, não existe um conjunto de números que possa ser aplicado mecanicamente a qualquer sistema.
Métrica de negócio não substitui qualidade, segurança e risco
As quatro métricas ajudam a responder a uma pergunta específica:
o agente está se tornando útil para a operação?
Elas não respondem a todas as perguntas necessárias para colocar um sistema de IA em produção.
Um agente pode ter excelente volume de conclusão e ainda apresentar problemas graves de segurança.
Pode reduzir custos e produzir decisões incorretas.
Pode diminuir os escalonamentos justamente porque não reconhece quando deveria pedir ajuda.
Por isso, métricas operacionais precisam conviver com avaliações de qualidade e risco — inclusive as decisões de privacidade e monitoramento que acompanham qualquer sistema em produção.
Dependendo do caso, também pode ser necessário acompanhar taxa de erro, precisão no uso de ferramentas, aderência a políticas, segurança, latência, custo computacional e qualidade das respostas.
O NIST recomenda que os sistemas sejam avaliados não apenas antes da implantação, mas também de forma contínua durante a operação. Em materiais recentes sobre o monitoramento de sistemas de IA implantados, o instituto discute os desafios de acompanhar o comportamento desses sistemas depois que entram em uso, identificar resultados imprevistos e observar consequências que podem aparecer apenas na operação real.
Em outras palavras: um bom resultado operacional não elimina a necessidade de controlar riscos.
Como montar um scorecard simples para um piloto
Não é necessário começar com um painel enorme.
Dezenas de métricas podem dificultar a decisão em vez de melhorá-la.
Para um primeiro piloto, um scorecard pode registrar cinco elementos básicos:
| Elemento | Pergunta |
|---|---|
| Objetivo | Que problema operacional queremos melhorar? |
| Baseline | Como esse processo funciona hoje? |
| Tempo até uso | Quanto levou para chegar ao uso real e quais gargalos apareceram? |
| Trabalho concluído e escalonamento | Quanto o agente termina e quanto ainda depende de pessoas? |
| Impacto | Que mudança observamos em tempo, custo, capacidade ou receita, conforme o caso? |
Depois, acrescente as métricas técnicas e de risco necessárias para aquele contexto.
Também vale definir previamente a frequência de revisão, quem será responsável pelos dados e quais resultados levarão a uma mudança no projeto.
O NIST recomenda identificar métricas adequadas, definir limites aceitáveis de desempenho e monitorar continuamente os sistemas em produção. Também sugere comparar sistemas de IA, quando apropriado, com modelos mais simples, desempenho humano ou outros referenciais manuais.
Essa comparação é particularmente útil porque impede que a pergunta seja apenas:
“Nosso agente melhorou?”
Ela passa a ser:
“Melhorou em relação a quê?”
Um exemplo prático
Imagine um agente criado para fazer a triagem de solicitações internas.
Ele recebe pedidos, identifica a categoria, consulta algumas informações, encaminha cada solicitação para a área adequada e escala casos ambíguos.
Antes do piloto, a empresa deveria entender como essa triagem acontece atualmente.
Quanto tempo uma solicitação espera?
Quantas são processadas?
Quais precisam ser encaminhadas manualmente?
Onde aparecem os erros?
Depois da implantação, as quatro métricas permitem acompanhar outra história.
Tempo até uso: quanto foi necessário para integrar o agente aos canais, dados e sistemas necessários?
Volume concluído: quantas solicitações ele consegue processar até o ponto definido como conclusão?
Escalonamento: quantas precisam de intervenção humana e por quê?
Impacto: houve alteração relevante no tempo de ciclo, na capacidade da equipe ou no custo por solicitação?
Agora temos uma visão operacional.
Ainda será necessário acompanhar qualidade, erros e segurança. Mas a discussão deixou de ser “o agente parece bom?” e passou a ser:
“O processo está funcionando melhor dentro dos limites que definimos?”
Essa é uma diferença pequena na linguagem e importante na gestão.
Não procure uma métrica perfeita. Procure uma decisão melhor.
Métricas existem para ajudar uma empresa a tomar decisões.
Continuamos com o piloto?
Expandimos para outro processo?
Precisamos reduzir permissões?
O problema está no modelo, na integração ou nos dados?
Devemos manter intervenção humana em determinada etapa?
O ganho observado justifica o custo e a complexidade?
Quando nenhuma métrica ajuda a responder perguntas desse tipo, provavelmente estamos medindo coisas demais — ou as coisas erradas.
É fácil acompanhar a quantidade de chamadas ao modelo, tokens consumidos, respostas produzidas e outras informações disponíveis automaticamente nas ferramentas.
Esses dados podem ser importantes para engenharia e controle de custos.
Mas um agente corporativo faz parte de um processo de negócio.
Em algum momento, portanto, a avaliação precisa voltar ao trabalho.
Conclusão
A pergunta não é se o agente é inteligente. É se ele é útil.
A adoção de agentes de IA traz uma mudança importante para a forma como avaliamos tecnologia.
Quando um sistema apenas gera uma resposta, podemos concentrar boa parte da análise na qualidade desse resultado.
Quando ele passa a executar tarefas, consultar sistemas, tomar caminhos diferentes e participar diretamente de processos, precisamos ampliar a avaliação — inclusive escolhendo agente, automação ou chatbot conforme o problema real.
O agente consegue entrar em uso?
Conclui trabalho de verdade?
Sabe quando precisa de uma pessoa?
Produz algum impacto relevante no processo?
E faz tudo isso mantendo os níveis necessários de qualidade, segurança e controle?
Essas perguntas são menos impressionantes do que uma demonstração cuidadosamente preparada.
Mas são muito mais próximas das decisões que uma empresa precisa tomar.
Um agente corporativo útil não é aquele que faz mais coisas sozinho. É aquele cujo papel no processo pode ser entendido, medido e controlado.
Antes de expandir o próximo piloto, defina o baseline, escolha as métricas que representam o trabalho e determine quais resultados justificariam continuar, ajustar ou interromper a iniciativa.
Na KaiporaLabs, esse é o tipo de avaliação que buscamos fazer antes de transformar uma demonstração de IA em parte da operação.
Quer avaliar onde um agente realmente pode gerar valor no seu processo? Solicite uma conversa de diagnóstico com a KaiporaLabs.
Leituras relacionadas
- Do piloto isolado para a IA integrada à operação — critérios e governança para transformar experimentos em rotina
- Agente, automação ou chatbot — qual problema cada abordagem resolve
- Produtividade corporativa e automação inteligente — mapear, medir, pilotar e escalar
- Privacidade e monitoramento como decisão de negócio — controles que acompanham a operação
Fontes
- NIST — Artificial Intelligence Risk Management Framework 1.0
- NIST — AI RMF Core: Measure
- NIST — AI RMF Playbook: Measure
- NIST — Challenges to the Monitoring of Deployed AI Systems
- IBM — What Is AI Agent Evaluation?
- IBM — AI Agent Testing
- Microsoft — Agent Metrics Reference
- Microsoft — Measure the Impact of Your Agents
As métricas apresentadas neste artigo formam uma estrutura prática para orientar a avaliação operacional de agentes corporativos. Elas não substituem avaliações específicas de segurança, privacidade, qualidade, conformidade ou risco, que devem ser definidas de acordo com o contexto de cada organização.